智能体赋能房土两税数据质量检测:从海量底表到一页看全的治理实践
房产税与城镇土地使用税(房土两税)的税源管理,一直是基层税务机关征管能力建设的重头戏。面对动辄数万甚至十余万条、几十个字段的税源底表,靠人工逐条翻查校验——效率低,而且容易漏检、漏判。
这一次,我们尝试用TaxBuddy 中的「财税数据治理」Skill来接管这件重复性极高、规则性极强的工作:让规则去校验、让机器去汇总、让图表去呈现,最终把“数据到底哪里有问题、哪个分局问题最多、两期对比是改善了还是恶化了”一次讲清楚。
1. 为什么要做房土两税数据质量检测
房土两税税源数据是征收房产税、城镇土地使用税的基础,其质量直接决定征管的准确性与公平性。但在实际工作中,税源底表常见三类问题:
必填字段缺失:行政区划、街道乡镇、坐落地址、占用面积等为空。
数据不正确:格式或合理性违背规范——社会信用代码位数不足、证书编号格式错误、面积金额低于合理下限。
逻辑关系矛盾:跨字段自相矛盾——从租计征却缺少出租原值与面积、租赁取得方式的土地却登记为土地使用权人。
传统做法依靠人工抽查或上级通报,覆盖面有限、反馈周期长。我们的目标,是用一套 规则驱动的自动化检测 对全量底表逐行校验,并输出可下钻、可追溯、可对比的检测结果。
2. 核心思路:规则驱动 + 自动化流水线
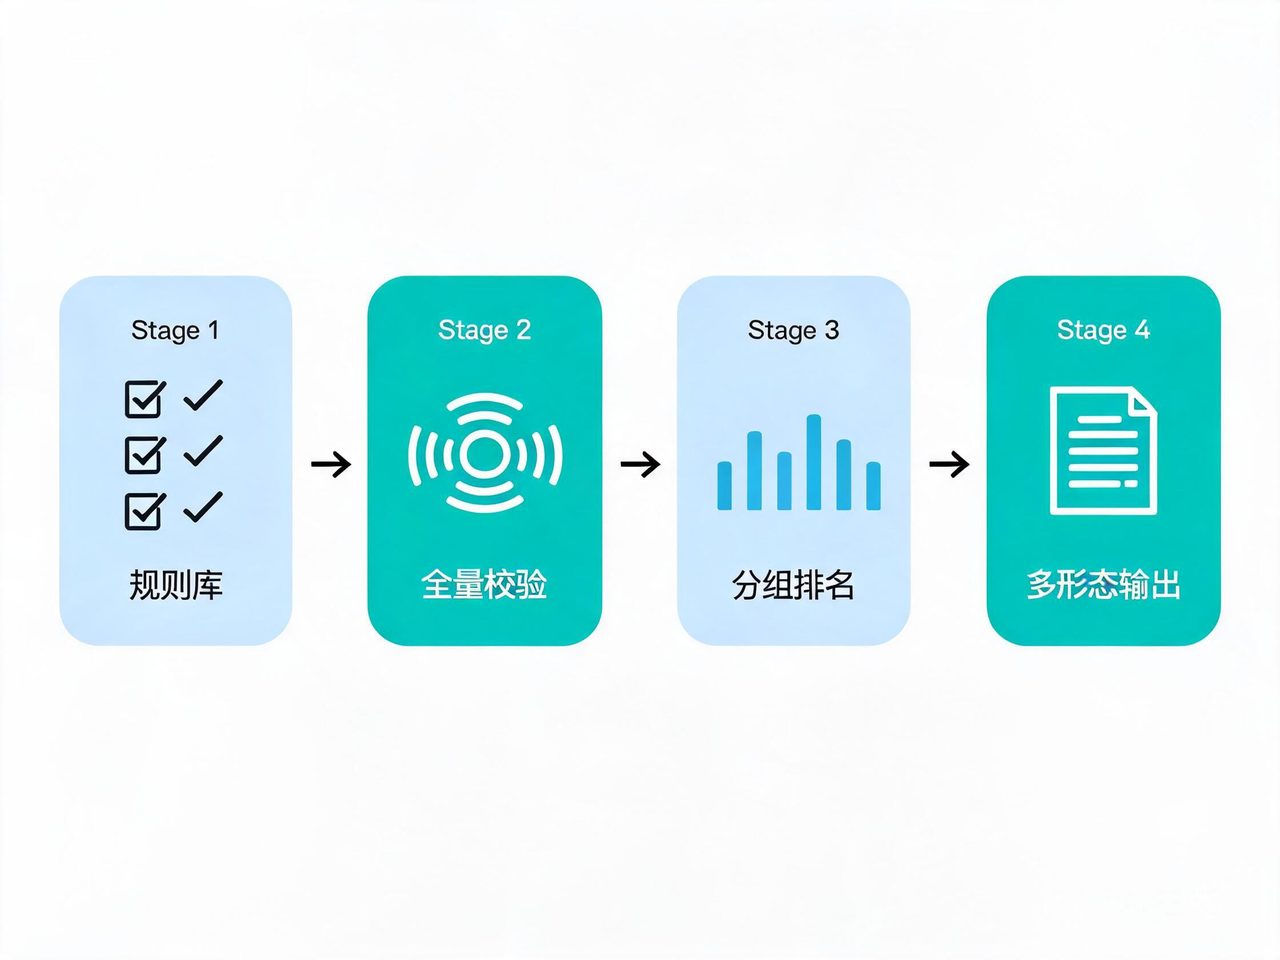
整个检测过程形成一条清晰的流水线,四步走完——
第一步:建立规则库
参照《房土风险感知-数据质量检测指标》,将校验规则分为三类:
必填类——不允许为空;
不正确类——格式与合理性(社会信用代码位数、证书编号格式、面积金额下限等);
逻辑类——跨字段逻辑关系(从租计征须同时有出租原值与面积、租赁取得方式不得为土地使用权人、地价不得小于取得成本之和等)。
第二步:全量校验
用向量化计算对税源底表(土地税源、房产税源各两期)逐行逐字段执行规则,标注每条记录命中的问题及所属类别。
第三步:分组汇总与排名
按“主管税务所(科、分局)”归集,以 问题率=问题记录数÷记录数 作为质量指标升序排名,排名第1即为质量最优;并对两期取数做对比,观察记录数、问题率、排名的变化趋势。
第四步:多形态输出
将结果沉淀为“统计报告+可视化仪表盘+纳税人级明细清单”三层成果,既有宏观概览,也能下钻到具体企业和具体规则。
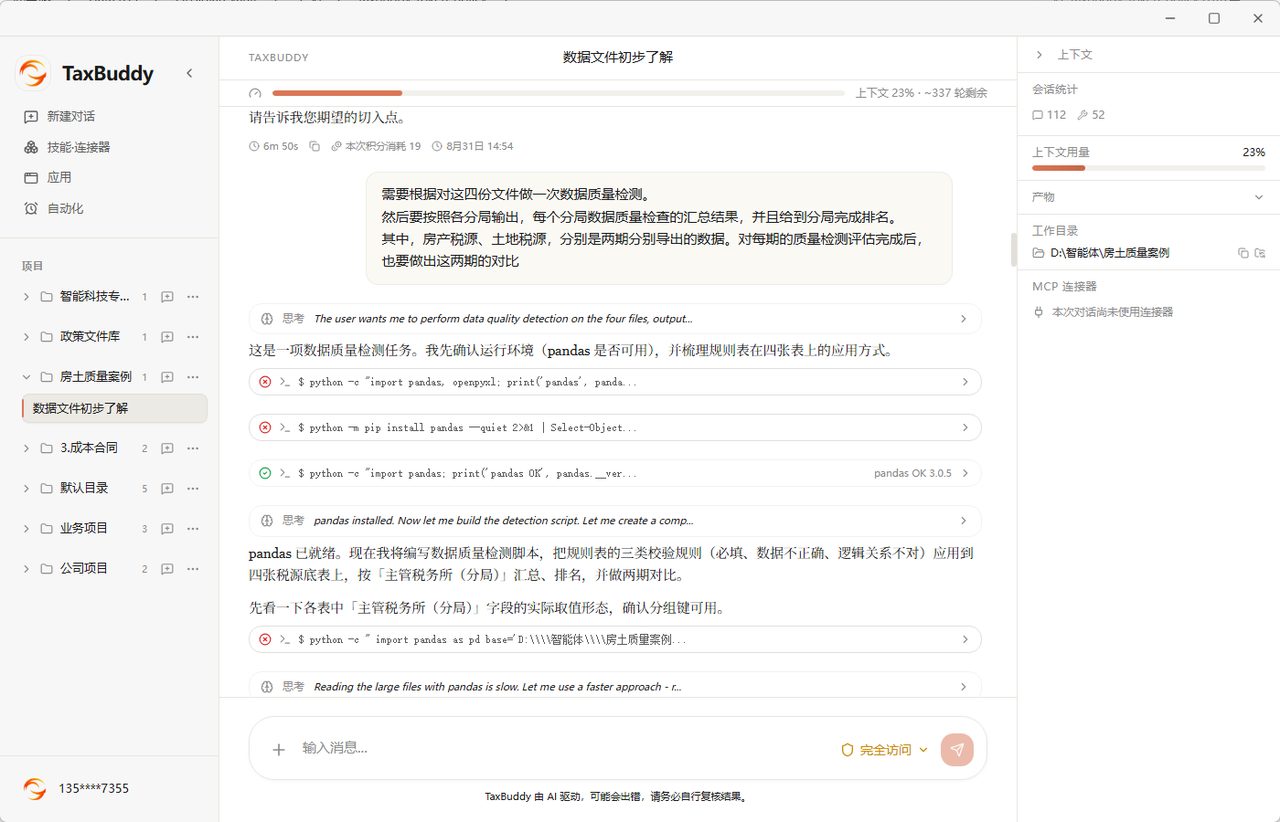
流水线搭好之后,实际场景里这套机制是怎么跑起来的?看一段 TaxBuddy 智能体的实际操作——
3. 四张底表的质检全貌
本次对土地、房产两类税源底表在临期(2025.6.30 取数)与末期(2026.1.5 取数)共四张表做了全量检测,结果如下:
| 税种 | 期次 | 记录数 | 问题记录数 | 问题率 | 备注 |
|---|---|---|---|---|---|
| 土地税源 | 一期 | 80,259 | 71,743 | 89.4% | 证编号/土地性质/权人信息缺失 |
| 土地税源 | 二期 | 86,175 | 65,090 | 75.5% ↓ | 整体质量提升,改善明显 |
| 房产税源 | 一期 | 67,041 | 44,776 | 66.8% | 从租计征缺出租信息/产权人缺证书号 |
| 房产税源 | 二期 | 73,517 | 45,281 | 61.6% ↓ | 整体质量提升 |
两税种末期的数据质量均明显改善——土地问题率从 89.4% 降到 75.5%,房产从 66.8% 降到 61.6%。
4. 三大产出物:看得见、找得到、查得清
统计报告(Excel)——给“看得见”
包含说明页、总体汇总、分税种×分期的分局汇总(含排名列)、两期对比、以及逐规则的命中明细,方便上级留存与数据归档。
可视化仪表盘(HTML)——给“一页看全”
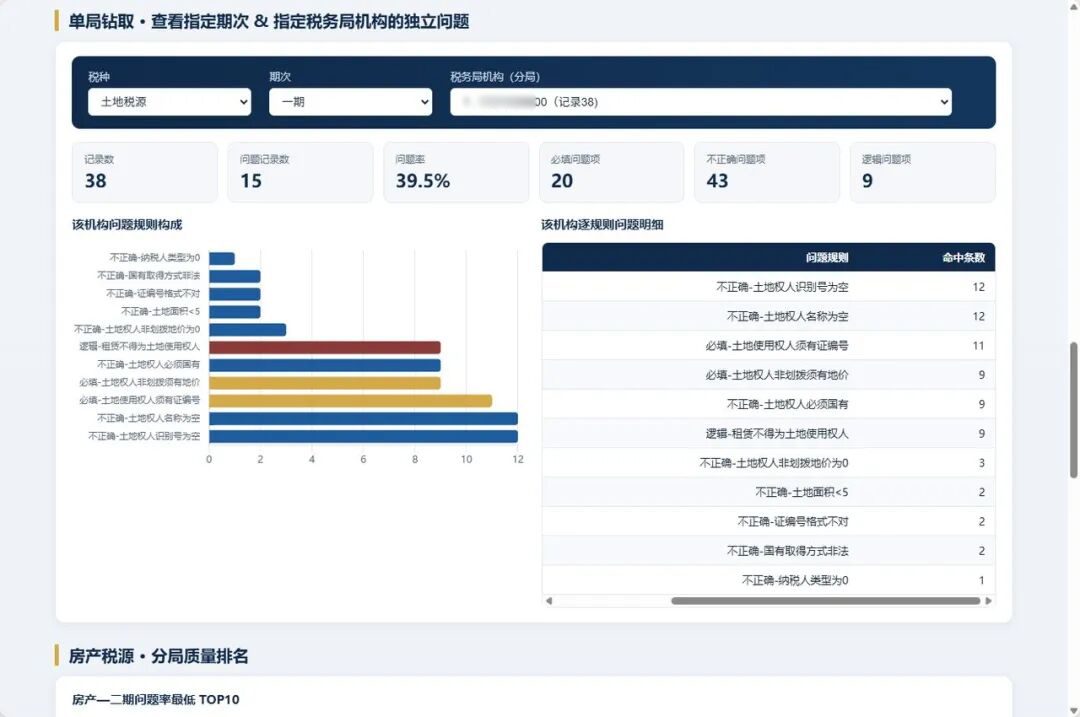
自包含的交互式网页,涵盖 KPI 概览卡、四表问题率总览、问题分类堆叠、分局排名 TOP10、两期变化对比、规则命中 TOP10、分局明细表。
还增加了 「单局钻取」 功能——先选税种、期次,再选具体税务局机构,即可查看该机构独立的问题构成与逐规则明细,做到“人人能自查、局局有画像”。
纳税人级明细清单(Excel)——给“查得清”
按税种分期分页,每行一条问题记录,精确到企业名称、社会信用代码、坐落地址、所属街道乡镇,并标注命中规则数与具体规则列表。任一税务局机构按“分局”列筛选,即可拉取本机构全部问题对象,直接用于整改。
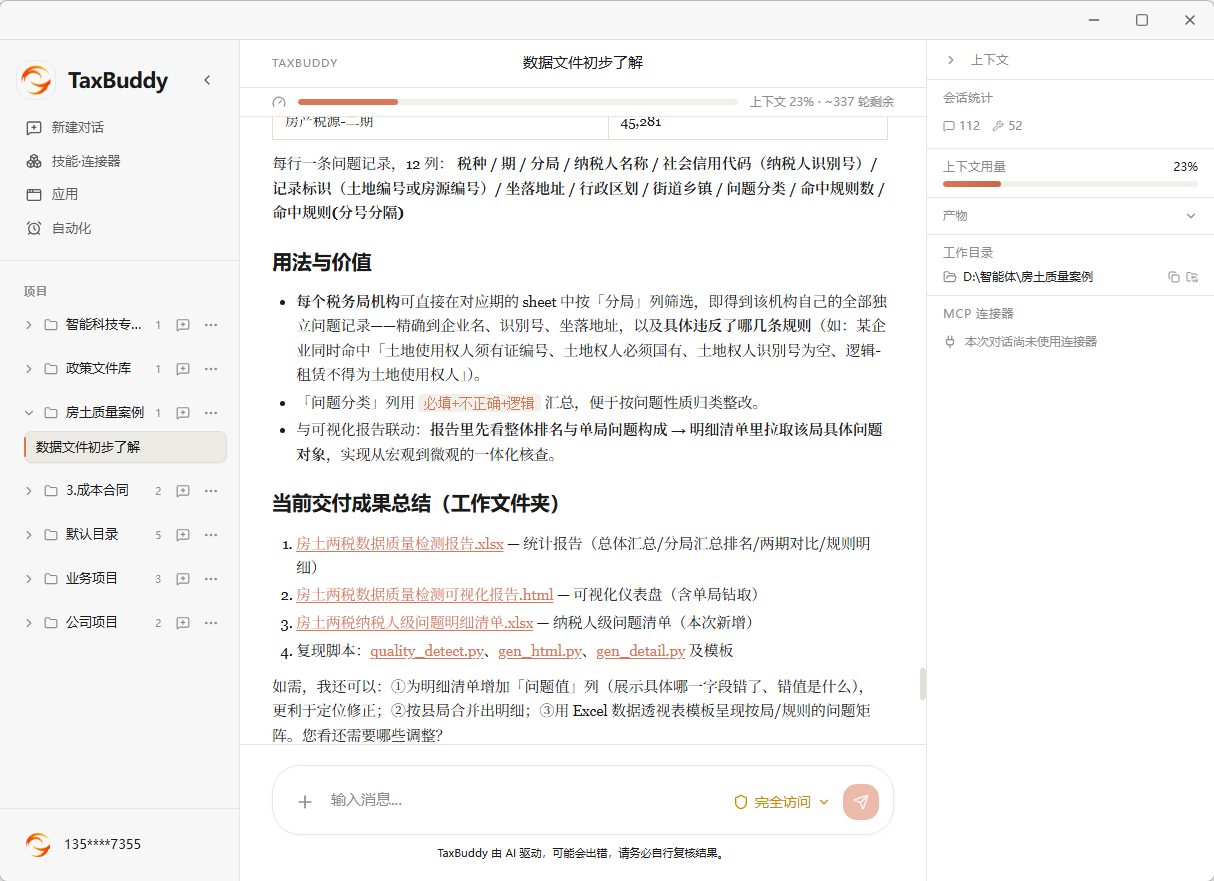
三份产出物加上完整复现脚本,最终落在工作文件夹里的具体文件——
5. 关键结论与治理价值
整体向好:土地问题率由 89.4% 降至 75.5%,房产由 66.8% 降至 61.6%,两税种末期的数据质量均明显改善。
进步显著:如某税务分局土地问题率由 98.1% 降至 43.1%,排名大幅上升,说明常态化检测确实推动了源头整改。
仍有顽疾:土地在“土地使用权人证编号/识别号/名称缺失、非划拨地价为0”等规则上两期均高发;房产集中在“从租计征缺出租原值或面积、产权人缺证书号”——这些应作为下一阶段重点整改方向。
这套方法的核心价值在于:把分散在人工经验里的“质检规则”沉淀为可执行、可复用的自动化检测能力——用“全区图”发现治理方向,用“分局画像”压实主体责任,用“明细清单”落到具体对象,真正实现数据质量治理的闭环。
6. 写在最后:智能体的活,才刚开始
本次实践验证了一个朴素而有效的道理:对规则明确、体量庞大的财税数据治理任务,交给“规则驱动的智能体”去执行,既能保证不重不漏、口径一致,又能解放人力去做更需要判断的分析与整改。
如果您的团队也在做房土两税、土地增值税或其他财税数据的质量监测与治理,这套“规则库+自动化校验+多形态报告+明细闭环”的范式,值得一试。
2026年8月31日,工信部发布《关于开展人工智能应用服务商培育专项行动的通知》,明确提出探索通过“首购首用、风险补偿”等模式,加大对大模型、智能体(Agent)及 Token(词元)服务的采购力度。
这份文件的信号很明确:国家从顶层设计上承认了“消耗算力”与“投入人力”在价值创造上的对等性。像房土两税数据质检这样的场景——规则明确、体量庞大、可标准化交付——正是智能体作为 “数字劳动力” 的典型用武之地。
TaxBuddy 已经支持一体机部署和私有大模型本地化运行——数据不出域、模型不走公网,满足信创要求。
想看 TaxBuddy 在您本地数据上的真实治理效果?
扫码加微信,备注“房土质检”,我们安排一次针对性沟通。
也可以与我们共同探索 TaxBuddy 在实际税务工作中的更多数字化场景与用法。